实验 (2):Deeper Research
本课程的实验是建议性质的实验,不记分;遇到困难的特性,可以选择逃课不实现。本实验延续实验 (1) 的 “个人数据库” 部分:在积累资料的基础上,让 Agent 更好地利用它们。即使没有完成上个实验,也可以从一个能检索资料、读写文件的 Agent 开始。
1. 背景
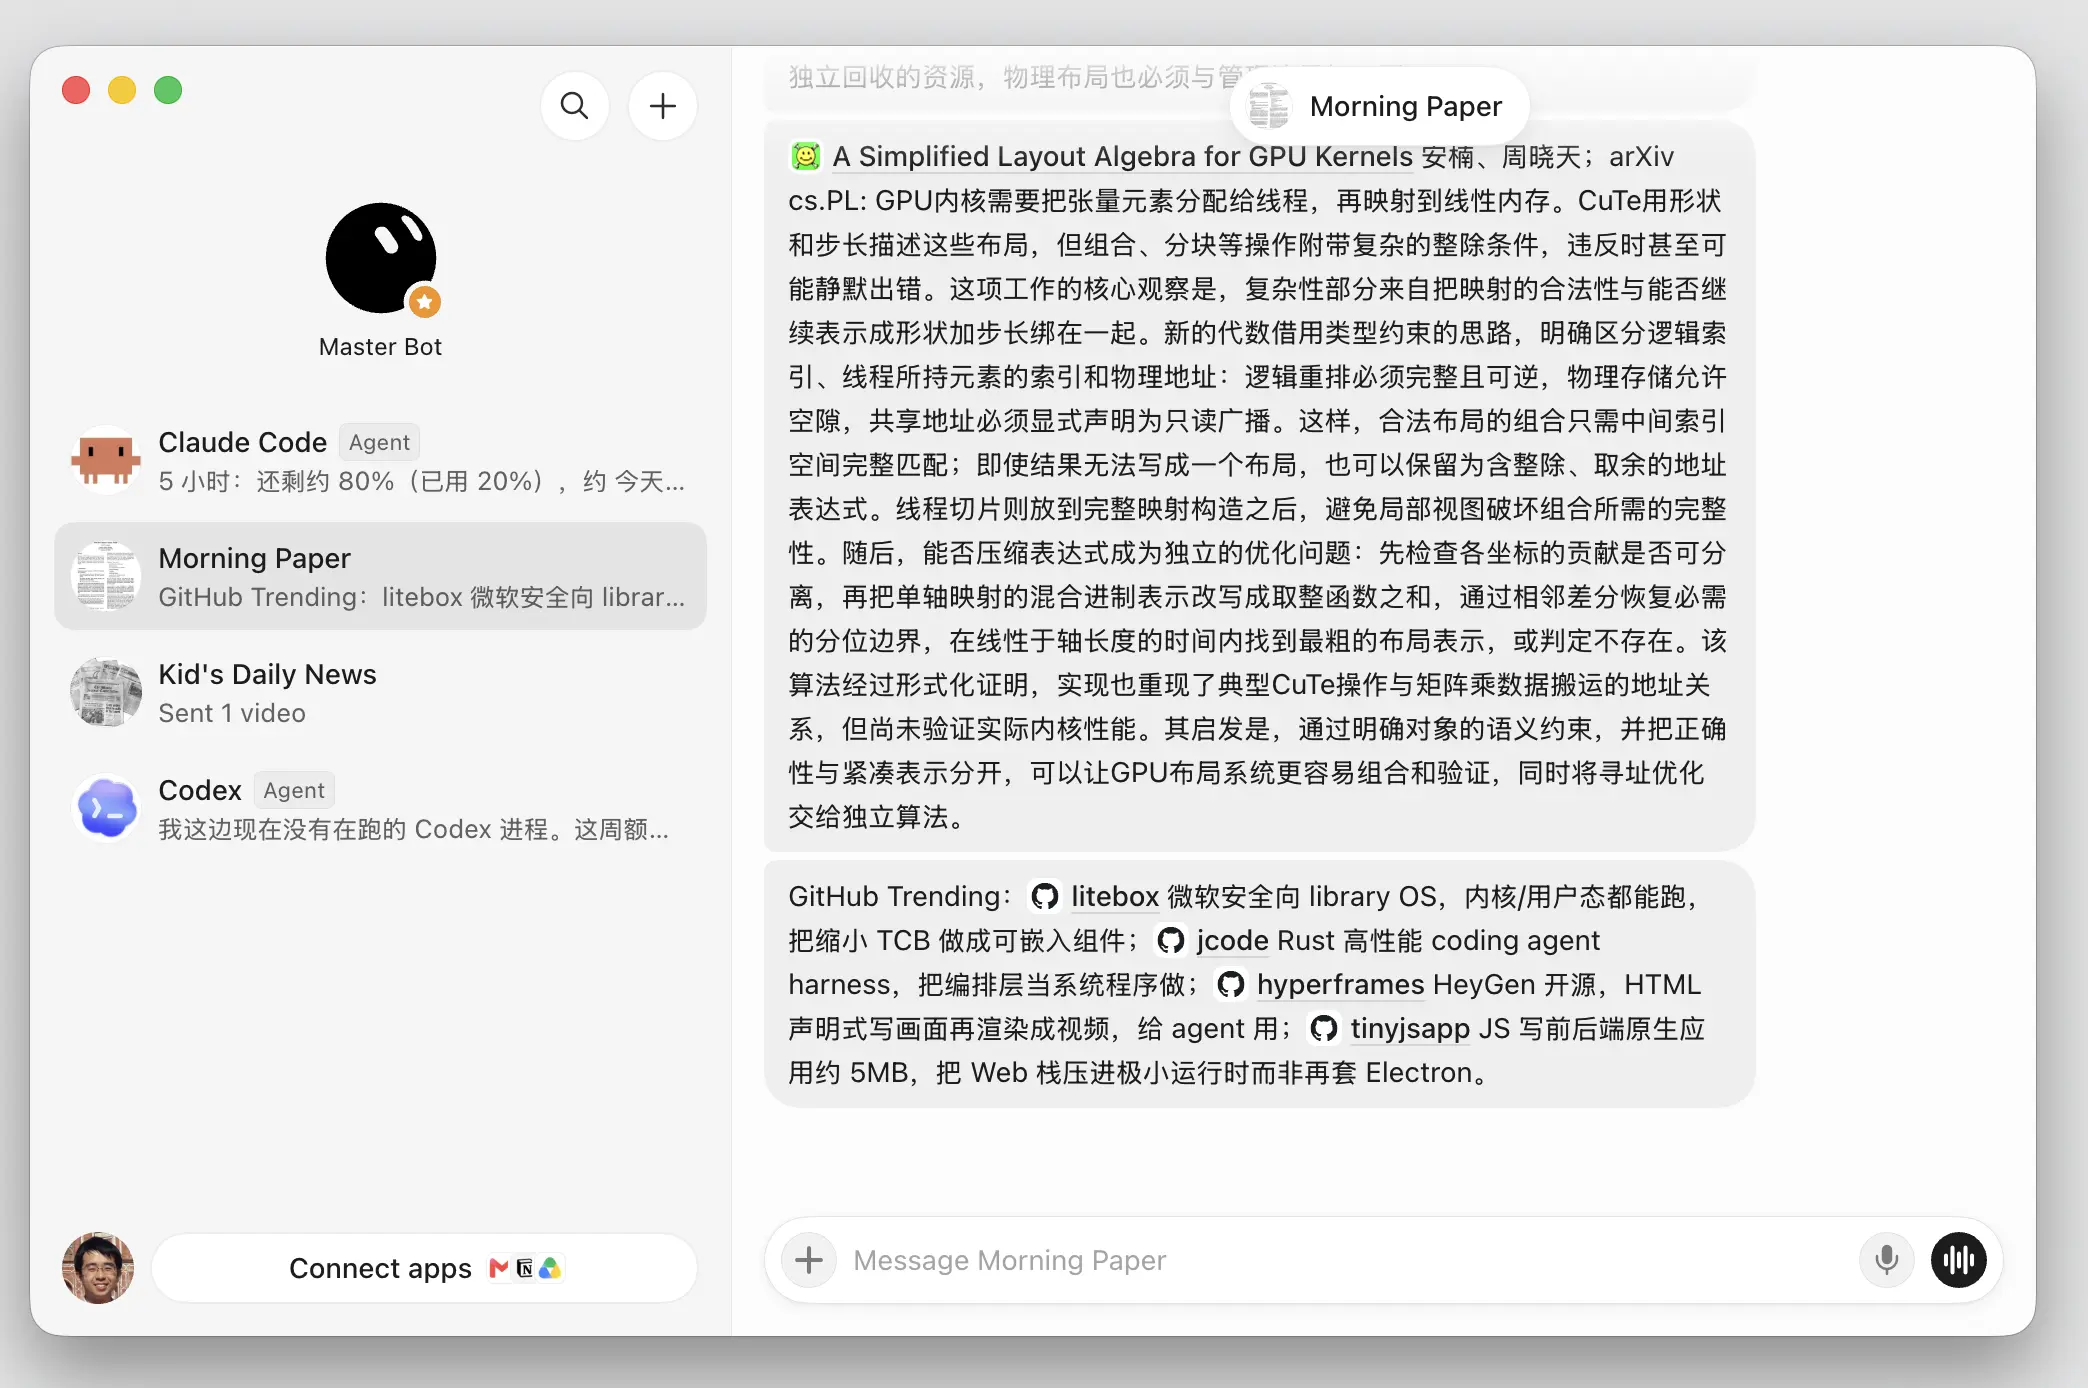
如果大家已经用上了上个实验的工具,你会发现它有点像你自己专属的 Grok-bot 类产品。云端托管的助手省去了自己配置运行环境的麻烦,降低了上手门槛。但作为 Computer Science 的学生,大家可能还希望有更多定制空间:手工精调 Prompt,接入自己的资料,或者实现产品没有内建的功能。例如,jyy 已经把不少 cron jobs 从常开的 Mac mini 迁移到了 bot 的定时任务,并借用 App 内的文件推送机制接收结果:
然而,当 Agent 开始理解你,而你也开始重度使用它时,你对它的期望会越来越高。上个实验的 Agent 也许已经能帮助你收发邮件,但要精读论文、交叉核对资料,或者完成复杂的编程任务,你可能又需要回到自己的 Coding Agent 上,亲自引导它反复查证和修改 (至少我仍然把所有工作相关的信息都维护在本地文件系统中,包括数据、脚本、skills 等)。
那么,能不能把这个过程也交给个人助手?是时候让 Agent 收集更多维度的资料,让 Agent 用更长的循环时间换更好的结果。
2. 实验要求
在保留 Agent 基本使用方式的基础上,增加一个额外的 effort 选项,调节它投入的计算预算。目标是让它在更高的努力程度下,通过更多探索、查证和修改,得到更好的结果。
2.1 算力换智力
今天的 Agent 已经具有完成长程任务的能力,但 “品味”,或者说对解决问题方向的直觉,还有待提升。有经验的 problem solver 会结合 breadth-first search 和 depth-first search:先在设计空间中广泛采样、评估,再深入有希望的方向。相比之下,Agent 有时会在收到指令后,直接沿着第一个想到的方案一路走下去 (我自己带学生的时候,也发现许多博士生有这种想到一条路就走到黑的倾向)。方向选对了,自然很快;但如果最初的几个决策发生偏移,就可能花了很多时间,也得不到理想的结果。
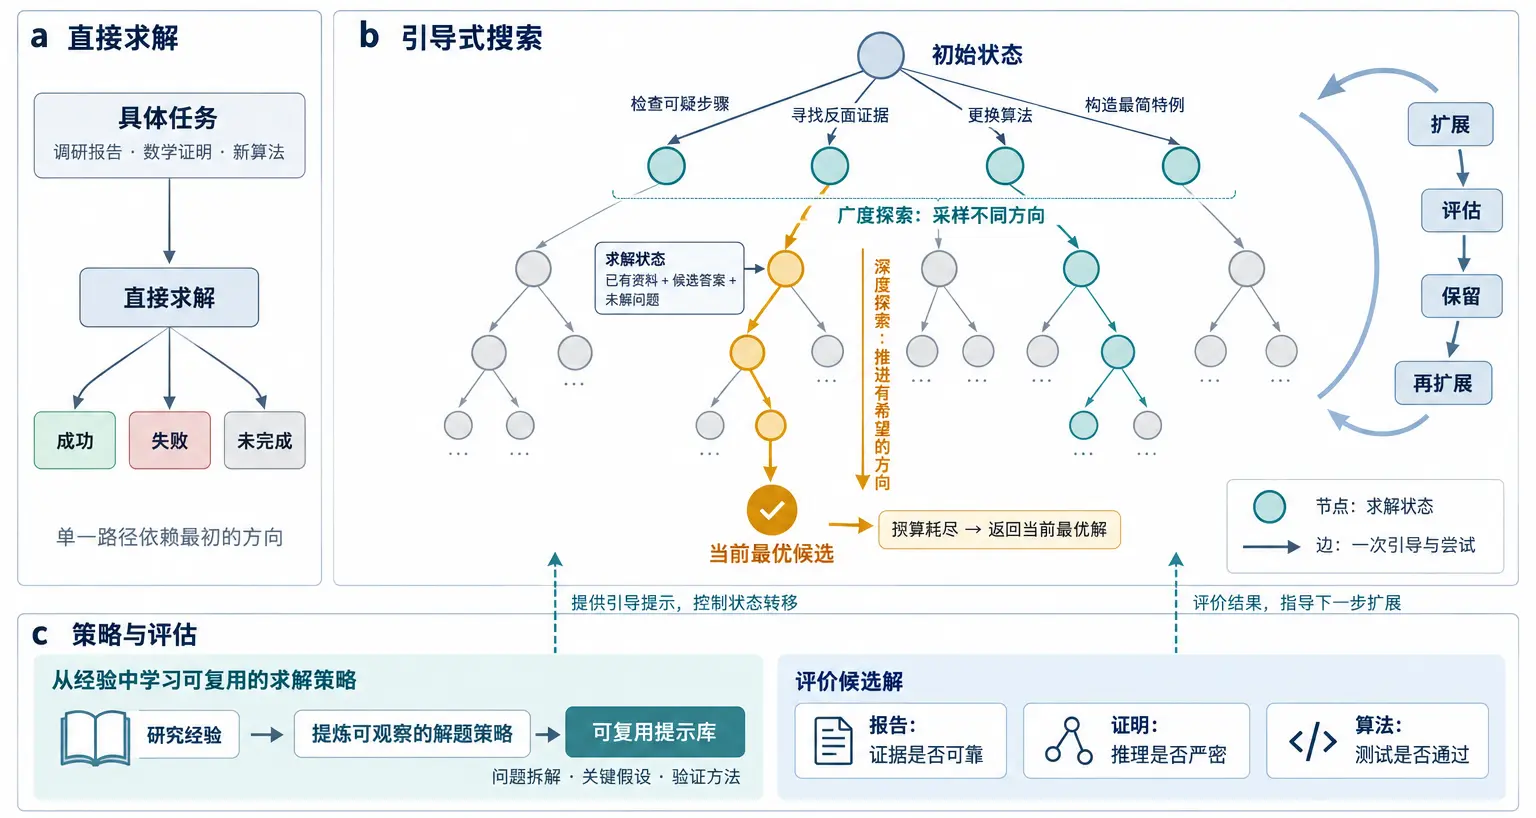
我们不妨把 problem solving 也建模成一个搜索问题。从一个具体任务出发,可以是调研报告、数学证明,或者提出一个新算法。关键是至少能比较两份结果的好坏:例如报告的证据是否可靠,证明是否有漏洞,算法能否通过测试。
最直接的方式是调用 solve(problem),让 AI 求解。它可能得到一份不错的结果,也可能失败,或者留下一份尚不完整的解。
但我们也可以先生成一段自然语言的 Prompt,调用 solve(prompt + problem),引导它尝试某个方向。把当前的资料、候选答案和未解决的问题视为一个 solve state,再注入下一段 Prompt。首先可以想到一些相对 high-level、却能显著改变搜索走向的 Prompt,让模型跳出固有思路,例如:“找出这个证明中最可疑的一步”“寻找支持相反结论的资料”,或者“换一种算法试试”。与此同时,你还可以借鉴已有的研究经验:把读过的研究论文重新消化,整理出其中的问题拆解、关键假设和验证方法,再提炼成可复用的 Prompt。例如,“先构造一个最简单的特例,检查当前猜想是否成立”。这里提炼的是论文中可观察的解题策略,不必猜测作者实际的思维过程。
每一步都在已有状态上继续求解,也可以从同一个状态出发尝试不同方向,就得到了一棵搜索树:节点是求解状态,边是一次新的引导和尝试。在预算耗尽之前,不断扩展、评估,并保留当前最好的候选解,最后反馈给用户。如果既能稳定地评估好坏,又能探索到有价值的新方向,就有机会实现算力换智力。这个思路可以类比 AlphaZero 的搜索,不过开放任务往往没有棋类那样明确的规则和胜负标准,评价本身也是难点。
从更实用的角度,这个循环可以做得简单一些,solve 也可以使用不同的模型和 harness (管理上下文、工具调用和执行过程的运行框架)。一个可参考的案例是 Humanize: Judgement Engineering for Agentic Coding:由不同厂商的模型分别承担实现和 review,再用明确的流程控制迭代;其中的内核优化应用还结合了知识库和性能测量反馈。
于是,一个可行的实现是维护一个持续更新的 Workspace,保存资料来源、当前答案、review 意见和历史较优版本。每一轮都做一次“求解 → 检查 → 根据反馈修改”,由 effort 控制最多执行多少轮,或者最多花多少 token。例如,低 effort 直接求解,高 effort 再检查关键结论、补充证据并修改。预算用完或已经满足验收条件时停止;新一轮没有改善,就保留之前更好的版本。
这只是一个起点,欢迎你做出自己的尝试:同样的预算,是多试几个方向,还是把一个方向做得更深?
2.2 上下文工程
上下文会影响模型后续的走向。你可以直接使用 Agent 自带的 Web Search,找到不少文献、资料和博客,但也许那个 “最重要” 的就被淹没了。如何在有限的上下文中放入真正有用的信息,仍然是一个 open problem。你可以尝试一些开源的框架,例如向量数据库,使 Agent 能在你构建的知识库中查找。在许多任务上,这都很有效,但在与它们交互的过程中,你也很容易发现它们的瓶颈。
2.3 评估效果
在这个实验中,很容易发生这样的事情:你兴致勃勃地实现了一个框架,花了很多 token,效果却甚至不如直接让模型一次输出。很多 AI 研究都面临这样的问题,这也是 benchmarking 很重要的原因。当然,对于自己付 token 费用的你来说,做严谨的消融实验 (逐项移除设计,判断各部分是否真的有用) 可能太昂贵了。作为一个简化的评估,你可以挑几个实际会用到的任务,固定输入资料和基础模型,分别运行直接求解、低 effort 和高 effort,并同时记录结果、耗时和 token 消耗。提前定好评价标准,例如事实与引用是否准确、需求是否完成、代码是否通过测试,避免看到结果之后才挑对自己有利的指标。
对于报告这类没有标准答案的任务,可以隐藏 effort 标签,打乱两份答案的顺序,再请自己或另一个模型比较,并要求指出具体依据。模型的评价也可能出错,关键结论仍要核查;条件允许时重复几次,避免把一次偶然成功当成稳定提升。评估本身也很消耗 token,因此本实验不强求完整的评测,先积累几个能看出改进和退步的真实案例即可。
最终的标准:这是你自用、“最懂你” 的 Agent;在使用的过程中,你会经常感到 “性能确实提升了”,并且愿意为多消耗的 token 付费。